Technologien und Themen wie Humanoide Roboter, Datensouveränität und World-Models sind mittlerweile auch für mittelständische Unternehmen von höchster Relevanz. Worauf es bei der Auswahl und Implementierung solcher Technologien ankommt, erläutert Prof. Dr. Ing. Sven Keller von der THM.
Herr Keller, was unterscheidet humanoide von Industrierobotern?
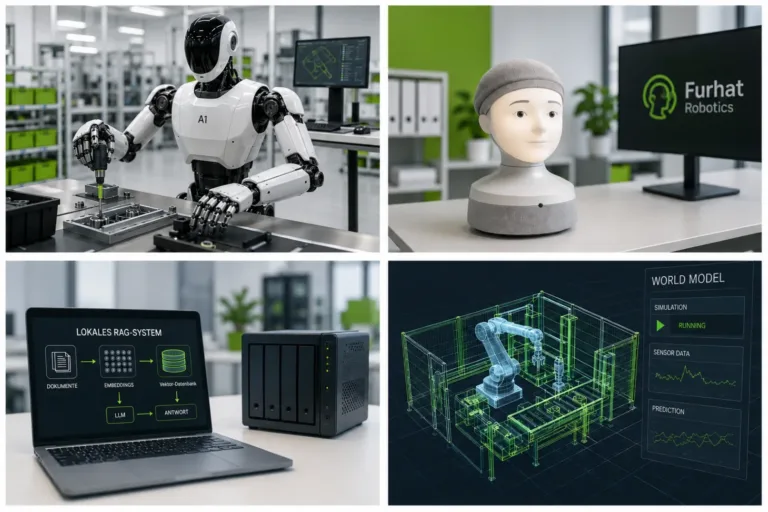
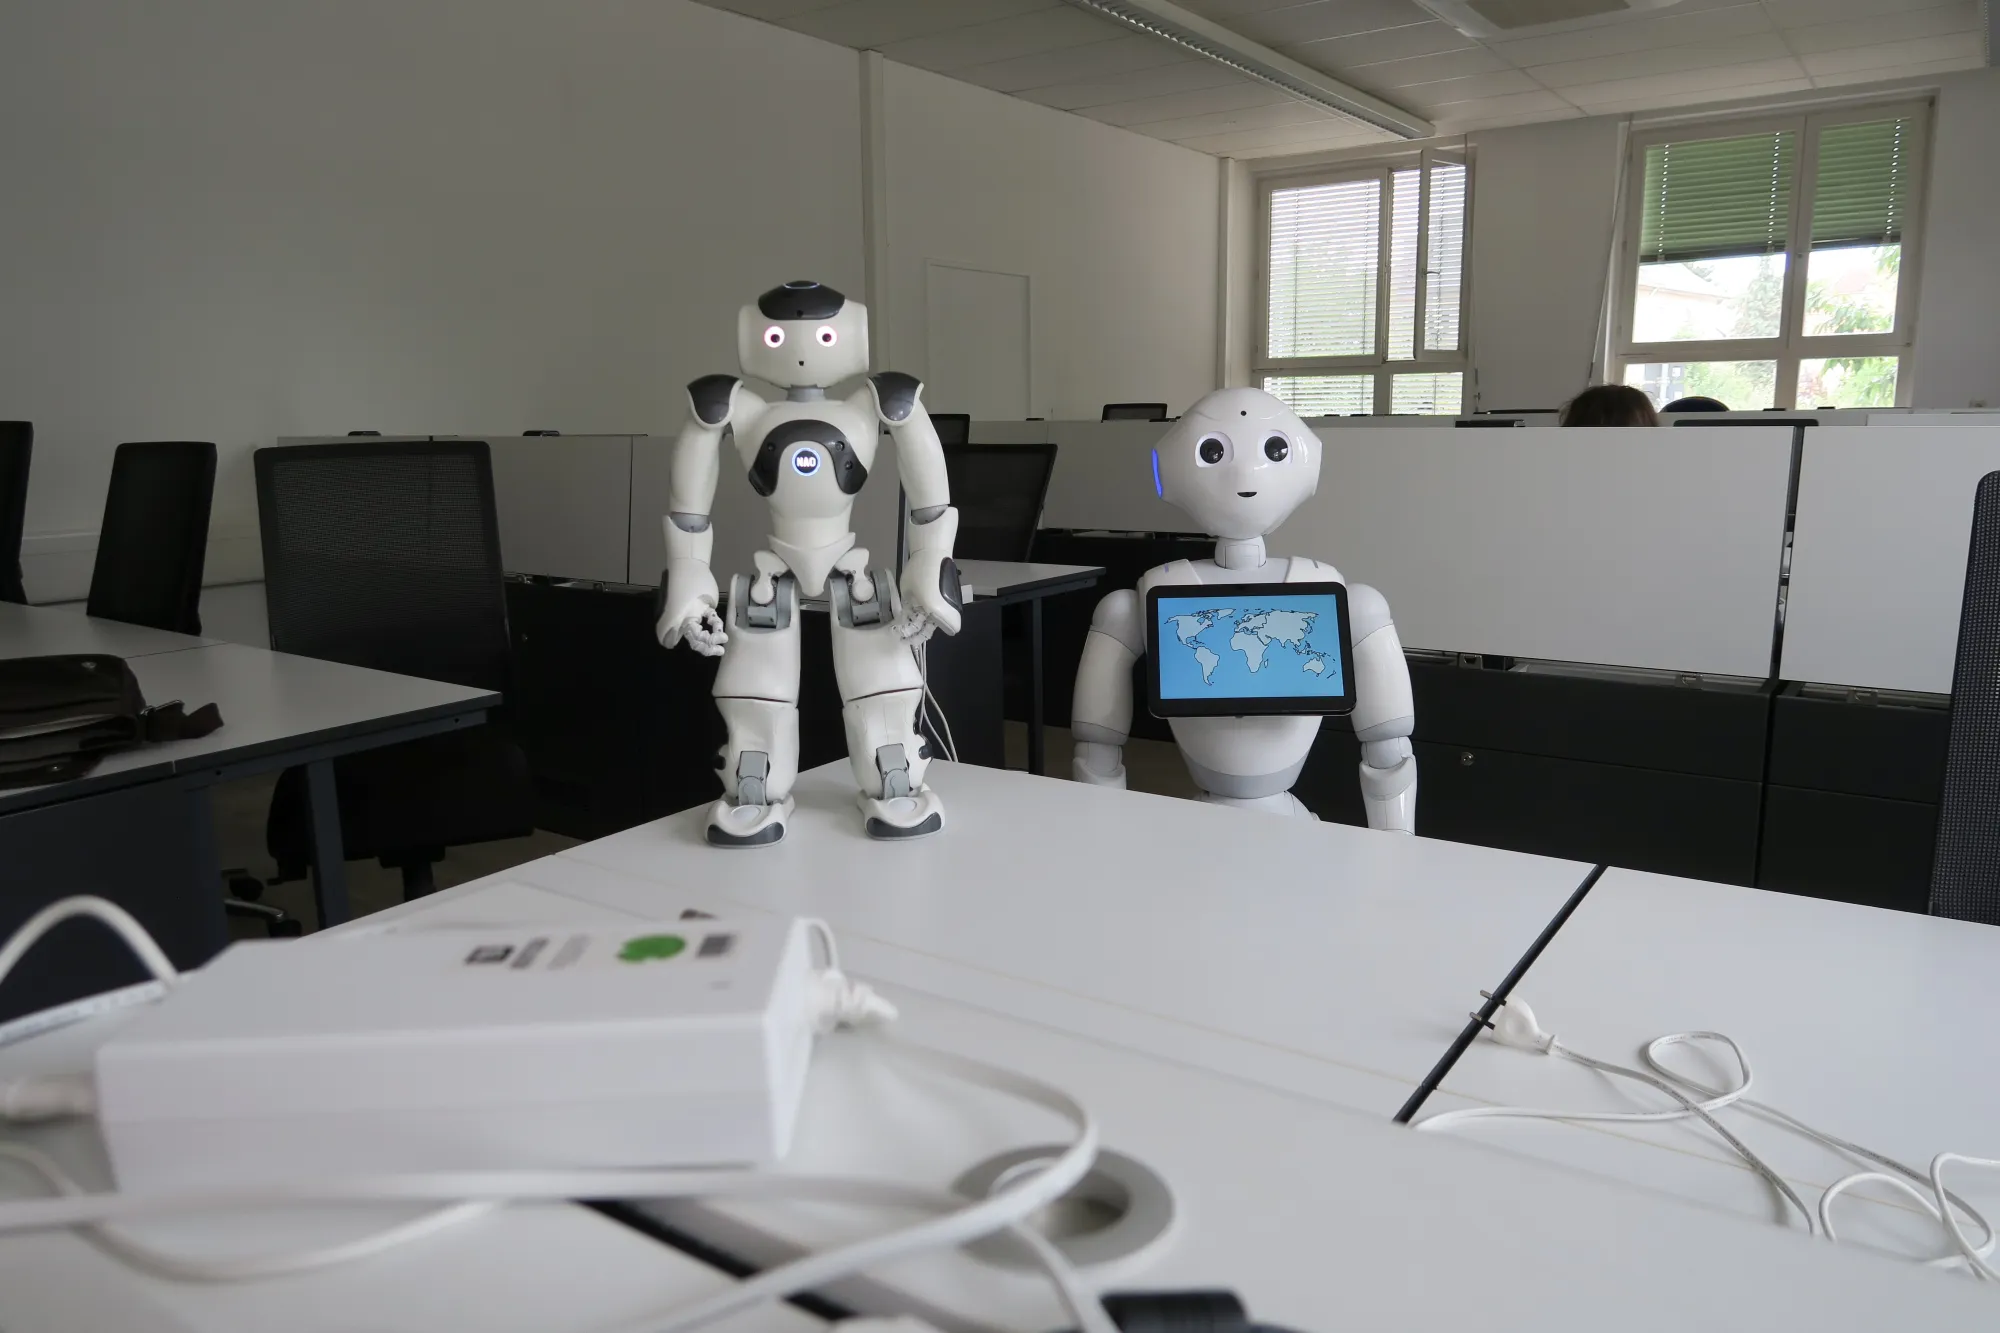
Anders als stationär montierte Industrieroboter haben humanoide Roboter eine sehr weitreichende Bewegungsfreiheit. Um sie zu nutzen, müssen sie trainiert werden.
Wo können humanoide Roboter in der Industrie eingesetzt werden?
Ein klassisches Einsatzgebiet ist der Montagebereich, wenn es um begrenzte Stückzahlen und wechselnde Aufgaben geht. Dabei können sie auch mit Menschen zusammenarbeiten.
Warum sind humanoide Roboter noch nicht sehr verbreitet?
Weil ihr Training sehr aufwändig ist. In einem auf Menschen zugeschnittenen Umfeld müssen sie ähnlich wie Menschen agieren. Dafür benötigen sie enorm viel Informationen aus der physischen Welt. Und das kostet viel Zeit und Geld.
Kann das nicht eine KI übernehmen?
Nein. Generative KI mit ihrer aktuellen Architektur ist damit überfordert. Sie ist in der Lage, große Datenmengen zu verarbeiten und schnelle Antworten in der digitalen Welt zu liefern. Aber um die physische Welt zu modellieren und mit digitalen Systemen zu verknüpfen, bedarf es erheblich mehr, und das können die derzeit führenden generativen Modelle nicht leisten.
„Jeder Prompt ist ein Datenexport. Das vergessen aktuell leider viele Unternehmen. Dabei gibt es bereits gute Ansätze für geschlossene KI-Lösungen.“
Heißt das, dass es dafür eine andere Art von KI braucht?
Genau. Wenn wir humanoide Roboter zukünftig einsetzen wollen, brauchen wir ein sogenanntes World-Model, das die Brücke zwischen der digitalen und realen Welt schlägt. So eine KI hat im Moment noch nicht die Reife, wie wir sie bei generativen Modellen kennen. Es gibt aber gute Ansätze, die beispielsweise beim automatisierten Fahren genutzt werden.
Was unterscheidet eine klassische KI von einem World-Model?
Large Language Models arbeiten mit wahrscheinlichen Wortstrukturen. World-Models verarbeiten Sensordaten und räumliche Informationen, um die physikalische Welt und ihre Gesetze zu verstehen. Auf dieser Basis können sie Vorhersagen treffen und Handlungen für die Zukunft ableiten. Das können LLM-Architekturen nur bei weiter zunehmender extremer Skalierung von Trainingsdaten, Parameterzahl und Rechenleistung.
Wird an so einem World-Model gearbeitet?
Ja und es könnte der nächste große Coup von Google sein. Denn Google hat alles, was man braucht: eigene Hardware, nahezu unbegrenzt verfügbare Trainingsdaten inklusive des visuellen Wissens durch YouTube und das Knowhow, das für die Entwicklung eines World-Models erforderlich ist. Wenn es Google gelingt, das zusammenzuführen, überholen sie alle aktuellen KI-Modelle mit einer für die Realwelt wichtigen Physical AI.
Das wäre dann eine sehr einzigartige Lösung?
OpenAI postuliert seit kurzem eine Singularität – also eine Zeit mit einer einzigen, sehr dominanten oder sogar alles beherrschenden KI-Quelle. Für deren Entwicklung ist die sogenannte rekursive Selbstverbesserung – RSI erforderlich. Das bedeutet, dass sich das System eigenständig optimiert. Wir erleben solche Effekte derzeit in einem frühen Stadium, aber das heißt nicht, dass es am Ende wirklich KI-Singularität geben wird. Auch ist noch nicht klar, welche Eigenschaften sie dann haben wird.
Ist das nicht gefährlich – für die Daten von Menschen und Unternehmen?
Wir haben in der Vergangenheit gesehen, was passiert, wenn wir zu offen mit Unternehmensdaten umgehen und Wissen ins Ausland abfließt. Heute müssen wir entscheiden, ob wir das nochmal zulassen, indem wir unser gesammeltes Wissen in die Cloud stellen, so dass es jederzeit bequem per KI abrufbar und nutzbar ist.
Halten Sie diese Gefahr für real?
Wenn ich mir anschaue, wie Menschen und Unternehmen mit KI umgehen leider ja. Vieles, das besser im Wissenstresor liegen oder in der eigenen Cloud gelassen würde, wird einfach in KI- Systeme gepromptet. Häufig ohne dass die IT-Abteilung oder die Geschäftsleitung das weiß oder will – Stichwort Schatten-KI. Allerdings gibt es auch Fälle, bei denen das im Rahmen der internen Compliance-Regeln sogar zulässig ist.
Kann man dagegen nichts machen?
Doch, man kann KI nutzen und gleichzeitig seine Daten schützen. Am besten geht das, indem man ein lokales oder geschlossenes RAG-System nutzt. RAG bedeutet Retrieval Augmented Generation und ist, kurz gesagt, die Optimierung von Antworten aus Large Language Models. In einem RAG-System können auch sensible Daten mit einer lokalen KI oder einer EU-AI-Act- konformen KI verarbeitet werden.
Ein lokales RAG-System ist aber vermutlich sehr aufwändig und teuer?
Früher war es das. Mittlerweile sind viele neue und gute mittelgroße Modelle auf dem Markt, die sich oft auch schon für Unternehmen mit rund 100 Mitarbeitenden rechnen. Sind diese etabliert, wird es wenig später sicher auch wirtschaftliche Lösungen für kleinere Unternehmen geben.
Arbeiten Sie auch an solchen Lösungen?
Ja, wir nutzen eine geschlossene KILösung auf Open-Weights-Basis – in Anlehnung an Open Source – mit der wir Daten intern halten. Dabei testen wir regelmäßig neue mittelgroße Systeme für diesen Zweck. Und wir entwickeln eine hybride Lösung, bei der automatisiert ein KI-basiertes Routing der Prompts durchgeführt wird.
Wie funktioniert Ihre hybride KI-Lösung?
Wir entwickeln eine Infrastruktur basierend auf Open-Source-Systemen, bei der eine KI den Inhalt jedes Prompts prüft und entscheidet, ob dieser intern oder extern zu bearbeiten ist. Allgemeine Informationen, beispielsweise zu einer Messe, können nach extern geleitet werden. Die Auswertung einer sensiblen Statistik wird geschützt auf dem eigenen Server oder in der zertifizierten Cloud durchgeführt. Hier wird sich in den nächsten Jahren noch viel entwickeln.
Vielen Dank für das Gespräch, Herr Keller.
Tech-Steckbrief
Technologien
🟩 Humanoide Roboter
🟩 Soziale Roboter
🟩 Datenschutz
🟩 Lokale RAG- und Agentensysteme
Einsatzbereiche in Unternehmen
🟩 Montage und Produktion
🟩 Logistik und Lagerhaltung
🟩 Verwaltung
🟩 Empfang und Service
Lehre und Forschung
Sven Keller bietet praxisnahe Studienmodule wie das Modul Human Robotic an. Hier lernen Studierende zunächst die theoretischen Grundlagen und programmieren anschließend selbst
einen humanoiden Roboter in interdisziplinären Teams.
Ergänzend zu den Lehrveranstaltungen betreut Sven Keller Bachelor- und Masterarbeiten in den genannten Bereichen und führt eigene Forschungsprojekte durch. Ein Beispiel dafür ist der
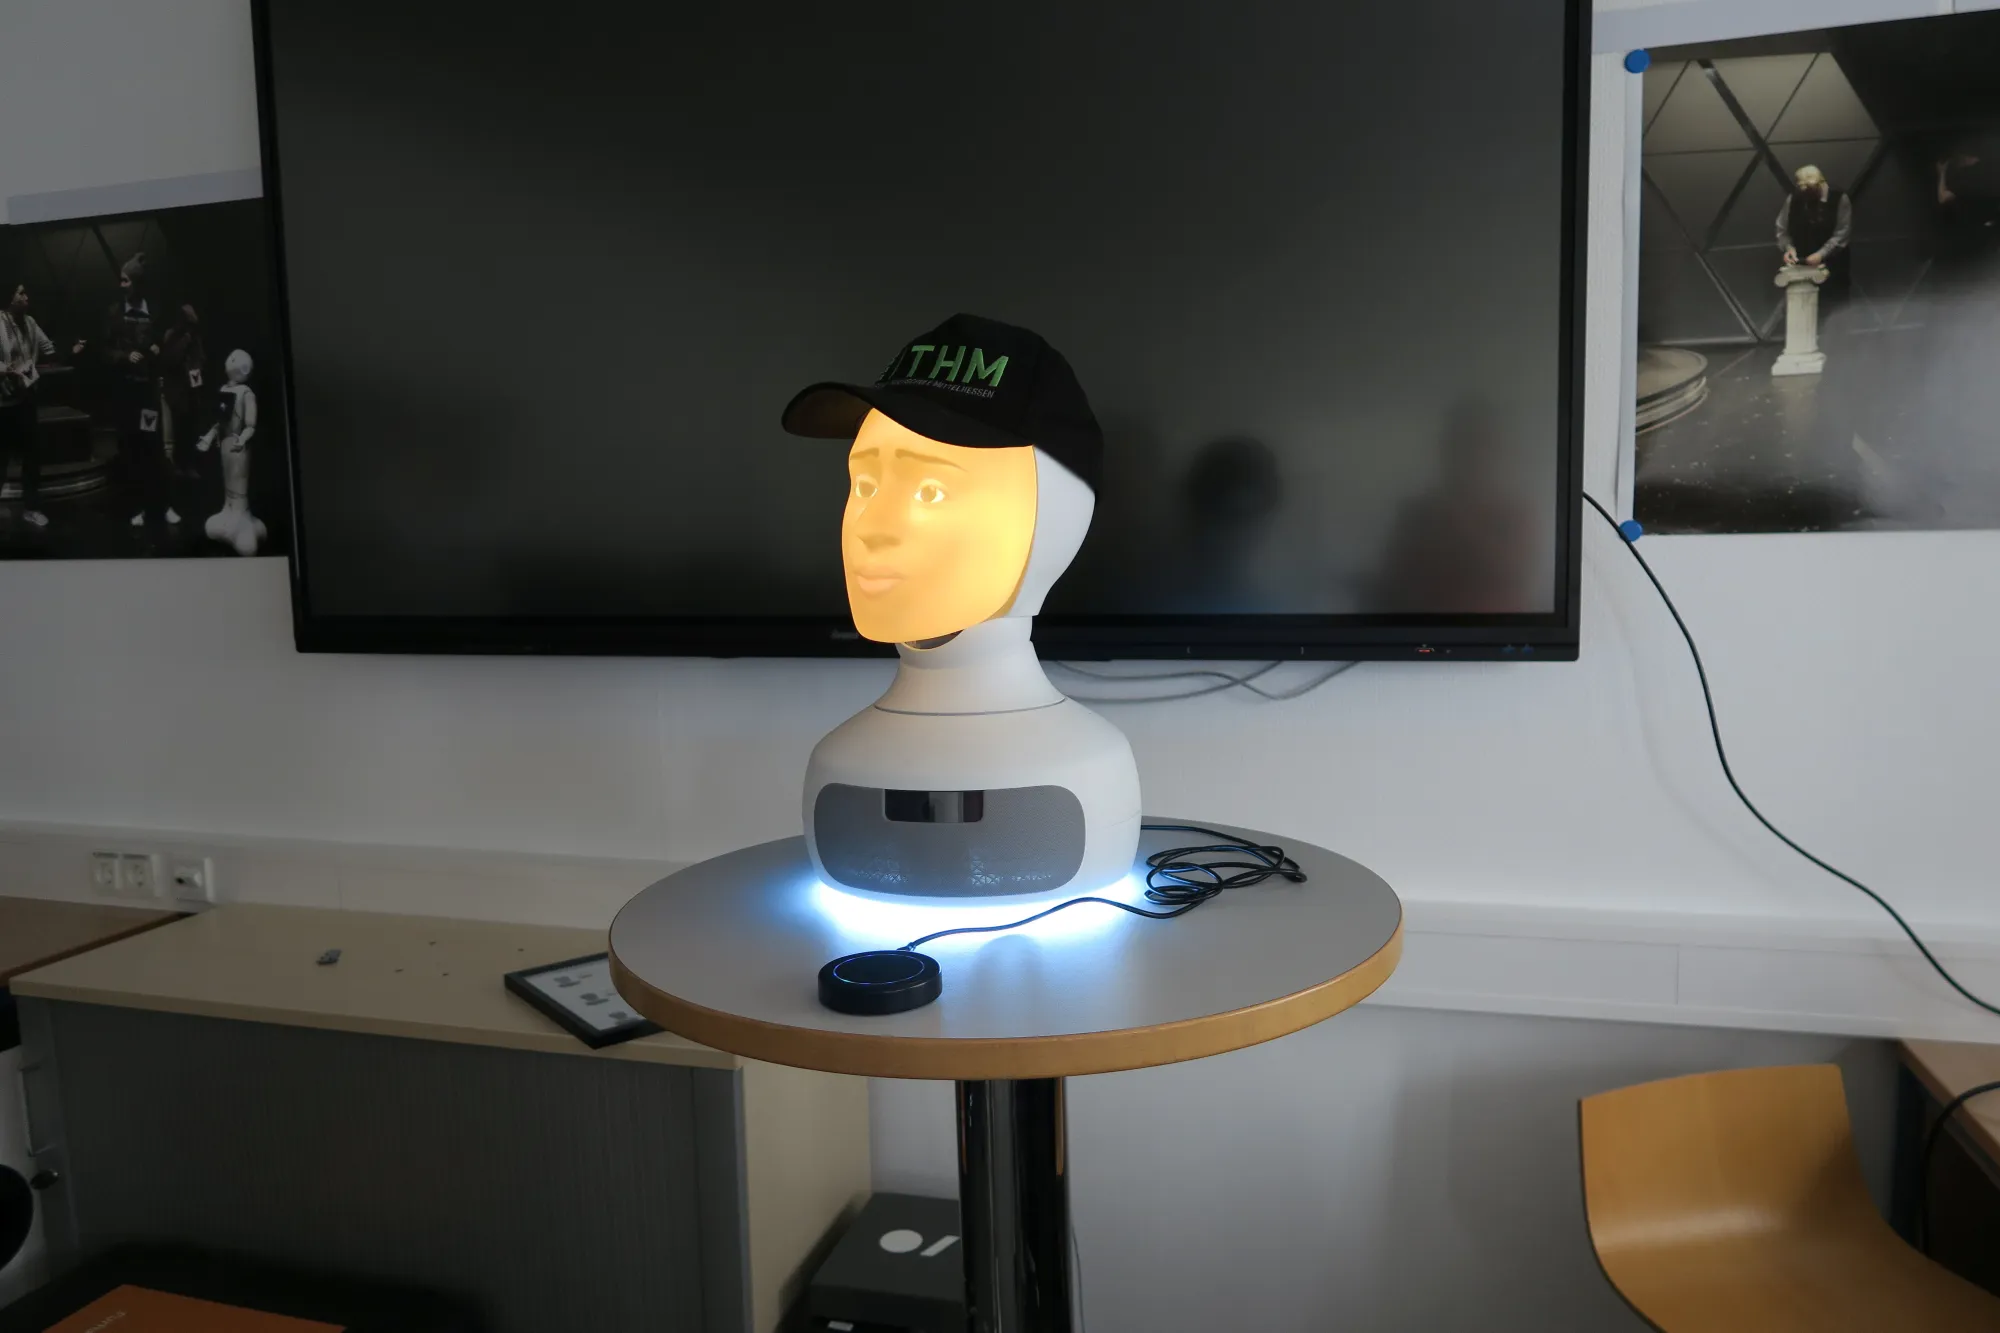
interaktive Social Robot Furhat, der in natürlicher Sprache mit Menschen kommuniziert und in Unternehmen eingesetzt werden kann.
Darüber hinaus nutzt der Fachbereich Wirtschaft an der THM ein eigenes, von Sven Keller aufgebautes lokales RAG- sowie Agenten-System und treibt dessen Weiterentwicklung voran.
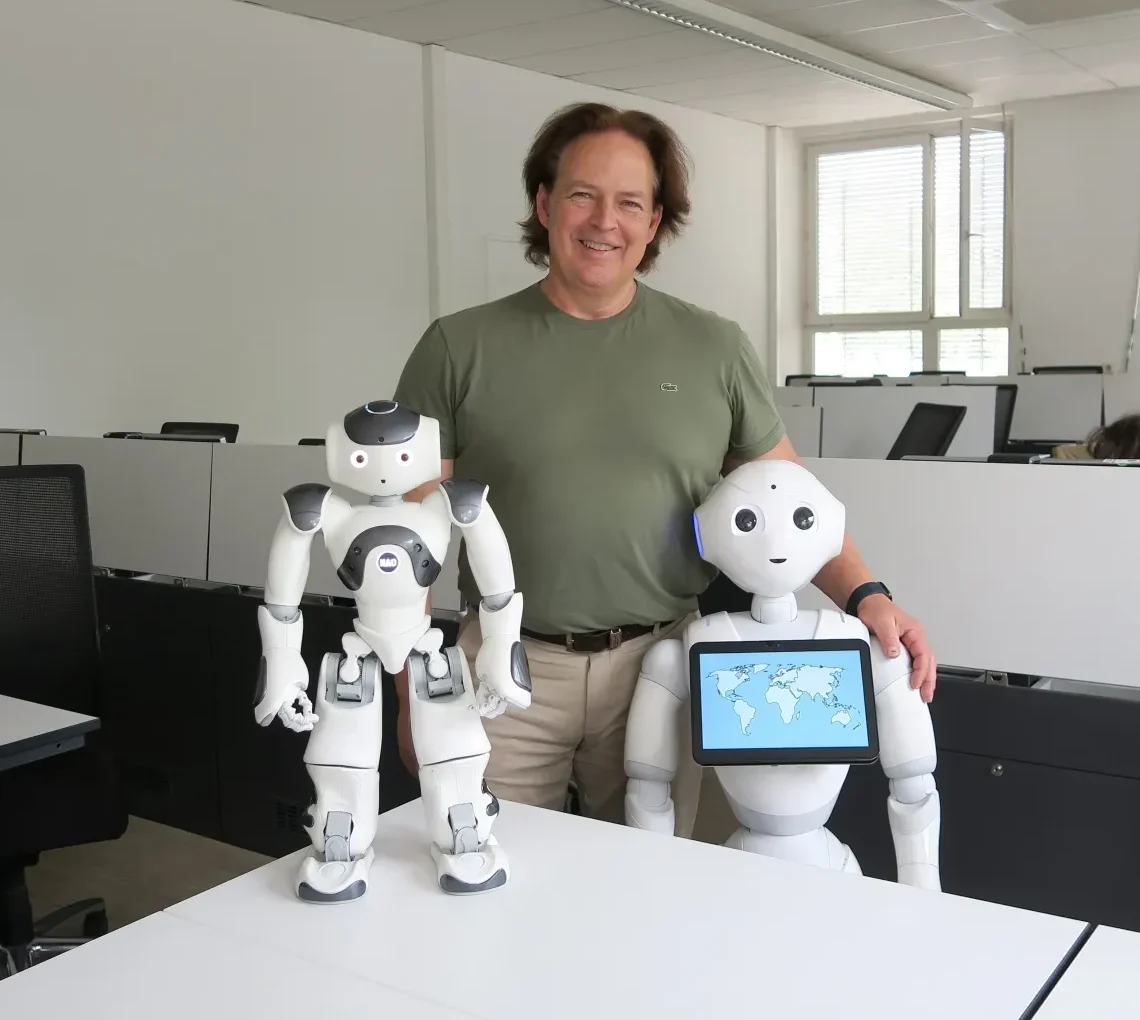
Prof. Dr. Ing. Sven Keller lehrt am Fachbereich Wirtschaft an der Technischen Hochschule Mittelhessen (THM) und beschäftigt sich mit dem Thema digitale Innovation. Ein Schwerpunkt seiner Arbeit sind humanoide Robotersysteme, deren Programmierung und Einsatzbereiche. Weitere Schwerpunkte sind die Themen Datenschutz und Datensouveränität im KI-Zeitalter.
Neugierig?
Möchten Sie mehr über die Angebote der THM zum Thema Humanoide Roboter, Datensouveränität und World-Models erfahren, dann wenden sich am besten direkt an Prof. Dr.-Ing.Sven Keller unter:
Tel. +49(0) 641 – 309 – 2729
E-Mail: sven.keller@w.thm.de